
Kubernetes 中运行 CubeSandbox 的部署与落地应用实践
作者|openFuyao 社区 Agent 沙箱 SIG · 王文涛(全栈工程师)/李爱华(Maintainer)
编者按| openFuyao 是面向通算和智算集群软件技术创新的开源社区,其算力基础设施统一构建在 K8s 上。openFuyao Agent 沙箱 SIG 团队把整套 CubeSandbox 搬进了 K8s 集群,目标是让沙箱计算节点像普通工作负载一样,被 K8s 弹性扩缩、滚动升级。
在实践过程中,openFuyao Agent 沙箱 SIG 团队通过多个层面的技术创新,实现了 K8s 管节点,CubeSandbox 管沙箱。这篇实践记录的是这项"分工"背后的技术思考和演进:哪些职责交给 K8s、哪些留给 CubeSandbox、边界画在哪里;路径上遇到的网络、进程、特性语义和调度问题,又该如何逐一解决。
一、为什么把 CubeSandbox 跑进 K8s
CubeSandbox 开源早期的时候,默认的部署形态是基于物理机直接部署。
- 控制面(CubeAPI / CubeMaster / CubeProxy / CoreDNS),Docker Compose 管理(MySQL/Redis)
- 计算面(Cubelet / network-agent / CubeShim / CubeHypervisor)以宿主机进程形式运行。
这套形态在裸金属单机或多机集群上开箱即用,但是在大规模集群管理上还存在诸多不便。
我们当前的算力基础设施统一构建在 K8s 上。所有工作负载的交付、调度、弹性扩缩、监控和配置,都由 K8s 承担。CubeSandbox 如果保留物理机部署形态,我们就要在同一个平台上维护两套运维体系:发布一套走 K8s CI/CD、一套走 systemd;监控一套接 Prometheus + K8s events、一套走宿主机 agent;证书、配置、密钥的轮转各走各的通道。心智成本是双倍的。
而我们期望的最终形态是:沙箱计算节点需要像普通工作负载一样被 K8s 弹性扩缩、滚动升级。
所以,我们把 CubeSandbox 的控制面、数据面和计算面都封装成标准 K8s workload,让 K8s 承担基础设施编排,让 CubeSandbox 自身承担沙箱的生命周期管理与调度。整体架构不侵入 K8s 的 APIServer、Scheduler、etcd 核心控制面,只使用 K8s 标准原语(CRD / Operator / 原生调度),不额外引入编排组件。我们此前已将方案作为 discussion #636(CubeSandbox on Kubernetes)提交到社区讨论。
二、基于 K8s 的部署架构
Cube Sandbox 各组件落到 K8s 上的映射关系:
| Cube 组件 | K8s 形态 | 关键点 |
|---|---|---|
| Cubelet + network-agent + cube-egress + CubeShim + CubeHypervisor | DaemonSet (Big Pod) | 特权 pod;挂 hostPath /dev/kvm、/data/cubelet 等;sandbox 运行在 Big Pod 内部 |
| CubeAPI / CubeMaster / CubeProxy | Deployment | Deployment+Service;其中 CubeMaster 挂载 PV,用于存储模版数据,防止重启之后,模版数据丢失 |
| MySQL / Redis | StatefulSet | 存储业务数据 |
| CoreDNS | 复用集群 CoreDNS | 配置 cube.app 的域名转发 |
表 1:基于 K8s 部署 CubeSandbox 方案
这套架构里的关键是:
- Cube Node 以一个 Big Pod 的方式运行,其中包含 cubelet/network-agent/cube-egress 关键业务组件;
- 负责节点侧沙箱的创建/销毁/快照/网络隔离;
- Big Pod 以容器网络的方式运行,沙箱网络信息基于 eBPF 管理,可以跟随该 Big Pod 的生命周期,防止污染主机网络,减少和其他 eBPF 网络管理的冲突。
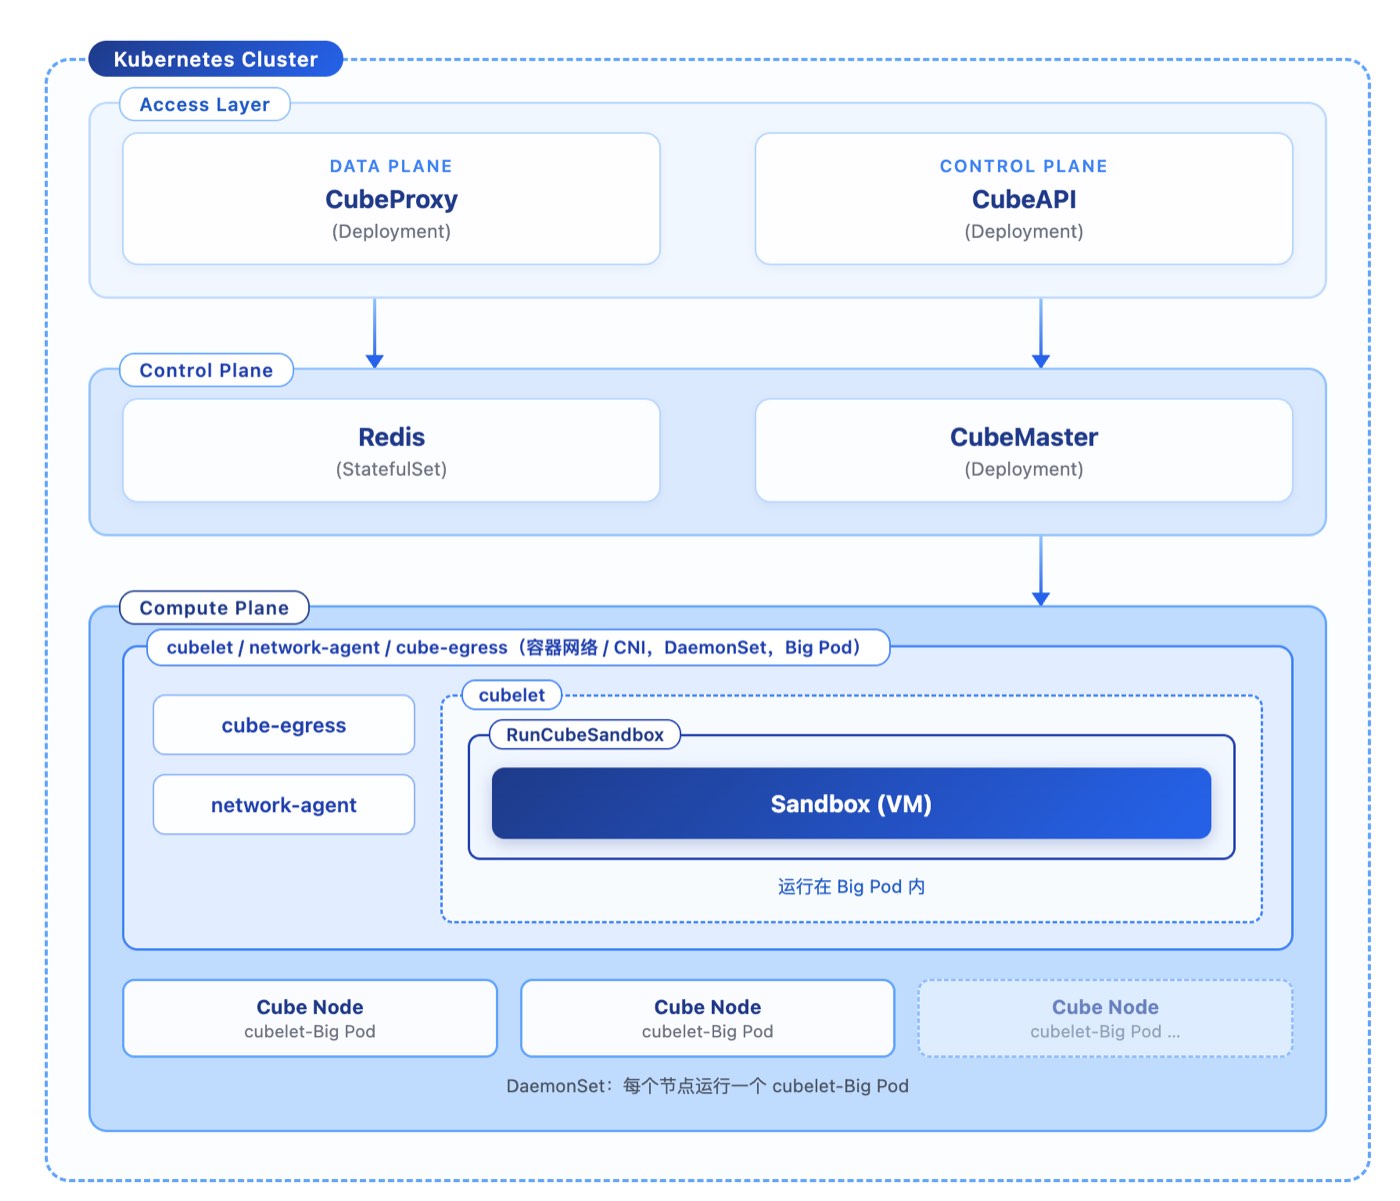
图 1:K8s Cluster 部署架构总图
如图所示,Access Layer / Control Plane / Compute Plane 三层,每个 Cube Node 都内含一个 cubelet-Big Pod,Big Pod 内嵌 Sandbox VM。
三、两个关键问题的发现与解决方案
3.1 同节点访问沙箱网络不通
把计算面运行在 Big Pod 之后,我们很快遇到最难忘的问题——把它整理成了 issue #443。
问题现象是:
- 宿主机节点 IP 76.0.121.10
- cubelet/network-agent 所在 Big Pod IP 172.24.205.149
- 沙箱 IP 192.168.0.3,监听端口 49999,eBPF 将端口映射到 Pod 端口 20007。
我们把现象整理成 5 个对照场景:
| 场景 | 来源 | 目标 | 结果 |
|---|---|---|---|
| 1 | 另一主机节点 76.0.145.47 | 76.0.121.10:20007/health | ✅ OK(在 76.0.121.10 上加了路由,把 :20007 转发到 pod 172.24.205.149:20007) |
| 2 | cubelet 所在 pod 自身(172.24.205.149) | 192.168.0.3:49999/health(直连沙箱 IP) | ✅ OK |
| 3 | 同节点另一个 pod cubeproxy(172.27.205.177) | 172.24.205.149:20007/health | ❌ 无响应 |
| 4 | 同节点宿主机 76.0.121.10 | 172.24.205.149:20007/health | ❌ 无响应 |
| 5 | cubelet 所在 pod 自身(172.24.205.149) | 172.24.205.149:20007/health(走 podIP:映射端口) | ❌ 无响应 |
一句话总结现象:只要流量从同节点进来、且目标是「映射端口」(podIP:20007),就一定不通;而跨节点(经节点物理 IP + 路由)或直连沙箱 IP 则正常。
我们从「现象」到「根因」的主要分析步骤:
- 先排除应用层:场景 2 能通,说明沙箱服务本身、TAP 设备、from_cube 方向都没问题;问题只出在「外部 → 映射端口」这条入向路径。
- 区分「跨节点」与「同节点」:场景 1 通、场景 3/4/5 不通,差异在:入向流量走没走节点物理网卡。这是最关键的一点。
- 使用 nettrace 抓包:通过抓包结果分析,发现跨节点的流量在内核转发正常,同节点流量转发只有进入的沙箱流量,没有从沙箱出来的流量。
- 在 TAP 设备上抓包:用 tcpdump 直接挂在沙箱的 TAP 设备上(形如 z192.168.0.3),跨节点的 SYN 正常到达;同节点来源的流量出现 cksum 问题。
- 看 BPF 程序与 map:bpftool prog show / bpftool map show 确认 from_world、remote_port_mapping 是否正常挂载、映射表里有没有 20007 → (tapIfindex, 49999) 这条记录。
- 修改 BPF 程序,添加关键日志:在 ebpf 程序中增加 bpf_printk 日志打印,用于数据转发丢包问题分析,对应的日志会打印到 /sys/kernel/debug/tracing/trace_pipe。
抓包结果和 eBPF 日志指向同一个根因:本节点流量经过 TAP 设备时 cksum 错误,被内核丢弃。代码走读确认了原因——eBPF 转发本节点流量时没有填充伪首部字段,checksum 校验必然失败。
这个 bug 背后是 CubeSandbox 上游在 virtio-net TAP 卸载能力上的一段演进史:
- v0.2.0(PR #110):hypervisor 向 guest 通告了 TSO/UFO/CSUM 卸载能力,guest 发出的 CHECKSUM_PARTIAL 包,一旦遇到不支持对应卸载的宿主机 NIC,就会引发网络异常、甚至影响同宿主机其他流量,官方因此在 v0.2.0 禁用了 virtio-net TAP 的 TSO/UFO/CSUM。
- v0.4.0(PR #505 + PR #469):官方把 bpf_csum_diff() 换成 bpf_{l3,l4}_csum_replace,并在 TAP 上启用 TX checksum/TSO 卸载,重新启用 TSO/UFO/CSUM(回滚 #110),同时取消了对宿主机网卡 disableGRO() 的要求。其中 PR #469 的关联 issue 里,就有我们提交的 issue #443。
issue #443 提交于 v0.3.x 时期,当时 TAP 卸载仍是禁用状态;计算面跑进 pod 之后,TAP 与 pod veth 之间的卸载语义不一致时,同节点入向包的 L4 checksum 就成了「没人补」的状态,表现就是「checksum 校验过不去」。我们提交 issue 推动了定位,最终修复由上游在 v0.4.0 完成。
3.2 cubelet 孤儿进程与 pod 里的 PID 1
这个问题当时发生的现象是:cubelet 进 K8s 之后 pod 无法正常运行。通过代码分析,问题出在 cubelet 自身的进程模型上——它设计时假设自己直接跑在宿主机 systemd 下,进了 pod,这套假设就和 PID 1 冲突了。
先看 cubelet 的启动流程(main.go:62-106):
这段流程说明:进程 A 负责建立独立的 mount namespace,fork 进程 B 继承该 namespace;进程 B 反过来杀掉进程 A 以释放资源、避免进程 A 持有 ns fd 影响后续清理。最终只有进程 B(孤儿)存活,运行真正的 cubelet 服务。
核心矛盾是:进程 B 杀死了自己的父进程(进程 A),变成孤儿。容器里的孤儿会被 reparent 到 PID 1。PID 1 一旦处理不当(比如 PID 1 就是进程 A 自身,或 PID 1 退出),容器就会崩溃。
我们的解法是给 pod 引入一个真正的 init 进程:tini 作为 PID 1,entrypoint 脚本后台起 cubelet,再配上 preStop hook 和 pidfile。
三个角色各管一件事:tini 负责 reap 孤儿、转发信号;bash 负责监控进程 B、触发清理;pidfile + preStop 保证外部信号能精确定位到真正的 cubelet 进程。这个组合下,cubelet 原有的"进程 A 建 ns、进程 B 继承并杀父"模型完整保留,我们不需要为 K8s 改一行 cubelet 代码。
四、Cube 特性移进 K8s 的四处语义平移
当前,在 K8s 场景下,我们使用了 Cube Sandbox 很多关键特性,例如 template 分发、snapshot 快照、pause-resume 暂停恢复、hostmount 主机挂载、egress 出站管控、网络策略、E2B 接口、ARM 适配等。
在使用的过程中,我们也遇到了一些问题,并将应对经验整理如下:
1、模板分发。 CubeMaster 的 templatecenter 负责把模板制品分发到各计算节点。在 K8s 里,模板制品落在计算面 pod 的本地盘,所以「分发」实际上是 CubeMaster → 各节点 cubelet 的点对点传输。如果 CubeMaster 或者计算面 Big Pod 重启,自身存储的 template 会丢失。
我们的经验是:针对 CubeMaster 重启丢失自身存储的 template,需要挂载 PV 持久卷;升级计算面 cubelet Big Pod 时,存储的 template,本地模板使用持久化 hostPath——让它跟随节点,而不是跟随 pod。
2、host-mount。 这个特性有一个语义陷阱:CubeSandbox 说的"宿主"是 cubelet 所在的机器,而 K8s 下 cubelet 自己就跑在 pod 里。要让真正的节点目录穿透到沙箱,计算面 pod 必须同时具备 hostPath 卷和特权模式,才能让真正的节点目录穿透到沙箱。
3、网络策略默认拦截 K8s 网段。 CubeVS 有一份「始终拒绝」的 CIDR 列表:10.0.0.0/8、172.16.0.0/12、192.168.0.0/16、127.0.0.0/8、169.254.0.0/16。而 K8s 的 pod/cluster IP 几乎都落在这些段里——这意味着默认情况下沙箱访问不了 K8s 内部服务(集群内的 API、数据库、其他 pod)。如果沙箱有诉求访问这些网段,必须用 allow_out 显式放行目标 service CIDR,否则会出现「沙箱连不上集群内服务」的问题。
4、network-agent 启动失败。 基于 K8s Pod 部署之后,network-agent 启动时要通过网卡获取 MAC 地址。当在 pod 的容器内部署之后就拿不到 MAC,导致启动失败。我们的方案是通过**「路由表解析网关 IP → 邻居表按 IP 精确匹配 → 宽松状态过滤」**这三步,先解决了 K8s Pod 环境下选错网关 MAC 的问题,同时通过接受 NUD_STALE/NUD_PROBE 等状态,容忍 Pod 启动时 ARP 缓存尚未刷新的场景。
五、K8s 调度与 CubeSandbox 自身调度的冲突
特性全部平移后,还剩最后一个"调度器冲突"问题。
CubeSandbox 有自己的调度器(CubeMaster,默认 overcommit_ratio 是 CPU 3 倍 / 内存 2 倍);而 K8s 也有 scheduler。两者的职责要分清楚,否则会有问题:
- K8s 调度的粒度是「计算面 pod」:决定哪个节点跑 cubelet、给多少 CPU/内存 request/limit。
- Cube 调度的粒度是「单个沙箱」:决定一个沙箱落在哪个 cubelet(节点)上。
冲突点在资源限制上。K8s 给计算面 pod 的 resources.limits 卡得很死,Cube 的 overcommit(CPU 3x)就会被 K8s 的 cgroup 反噬——Cube 认为自己还能装下更多沙箱,K8s 的 cgroup 已经把这个 pod 的 CPU 掐死了。
我们的规避方案是:K8s 调度限制在"节点级",沙箱装箱交给 CubeSandbox。建议计算面 pod 的 CPU/内存 limit 给足或不限,把装箱交给 Cube 自己的 overcommit 和物理负载保护;K8s 只负责这个节点是否运行 cubelet。
六、给其他团队的建议
经过真实场景中的实践和摸索,我们想给其他在 K8s 上落地 CubeSandbox 的团队三条建议:
- 把 K8s 调度限制在「节点级」,把沙箱装箱交给 CubeSandbox:计算面 pod 的资源 limit 别卡太死,否则 CubeSandbox 的 overcommit 会被 K8s cgroup 反噬。
- 网络策略要按需放行集群内 service CIDR:CubeVS 默认拒绝 10.0.0.0/8、172.16.0.0/12、192.168.0.0/16,沙箱连 K8s 内部服务要显式 allow_out。
- 计算面和控制面 pod 做专用 taint + system-node-critical 优先级:避免被 K8s 驱逐导致沙箱雪崩。
Cube Sandbox 在 v0.6.0 中已提供 K8s 原生部署方案,部署模式和自研搭建的部署模式类似,可以快速切换到社区原生能力上,基于社区模式可以借助生态的力量,更快速的演进。结合我们的业务场景,我们也希望社区继续构建五项能力:1)跨机暂停与恢复(v0.7.0 版本中已支持,预览版);2)跨机 Snapshot 启动沙箱(v0.7.0 版本中已支持,预览版);3)控制面和数据面隔离,并支持数据面无断服升级;4)更高的沙箱创建吞吐;5)兼容更多基于 eBPF 的 CNI 插件(如 cilium / calico)。