
换一个沙箱后端,要改多少代码?Agent 平台沙箱迁移的选型与实录
作者|Clivia(LambChat 作者)
编者按| LambChat 是一个集成 Skills 能力、支持多租户的 Agent 系统,它的沙箱层同时支持 E2B、CubeSandbox、Daytona 三种后端。
这篇文章,记录了这个项目在选择 CubeSandbox 时的真实踩坑:用户级持久绑定、四级查找链、Resume 后 504、bash -lc 登录 shell 环境问题。对那些正在做 Agent 平台、需要选沙箱后端的开发者,这些是可以直接参考的样本。
一、引言
LambChat 是一个集成 Skills 能力、支持多租户的 Agent 系统,后端使用 deepagents / LangGraph 构建。项目里有一个「数字空间」的概念:每个用户绑定一个属于自己的常驻沙箱,跨会话持续存在,不是每次对话新建一个。用户在里面装 Python 包、上传文件、让 Agent 自由折腾——正因为要让用户自由折腾,隔离性是硬需求,不能让一个用户的操作影响到其他用户或宿主系统。
选择 CubeSandbox 的理由很直接:KVM 硬件级隔离,每个沙箱有独立内核;snapshot/pause/resume 对用户级持久沙箱来说是刚需——空闲时自动 pause,下次请求自动 resume,内存态不丢;同时它的 API 兼容 E2B 协议,我们现有的 E2B 后端代码可以复用。
这篇文章想回答的问题很具体:一个已经在跑的 Agent 平台,沙箱从默认后端切到 CubeSandbox,到底要动多少代码、踩多少坑?
二、沙箱在项目里的位置:四层结构
LambChat 的沙箱层不是单一的"执行器",而是四层结构:
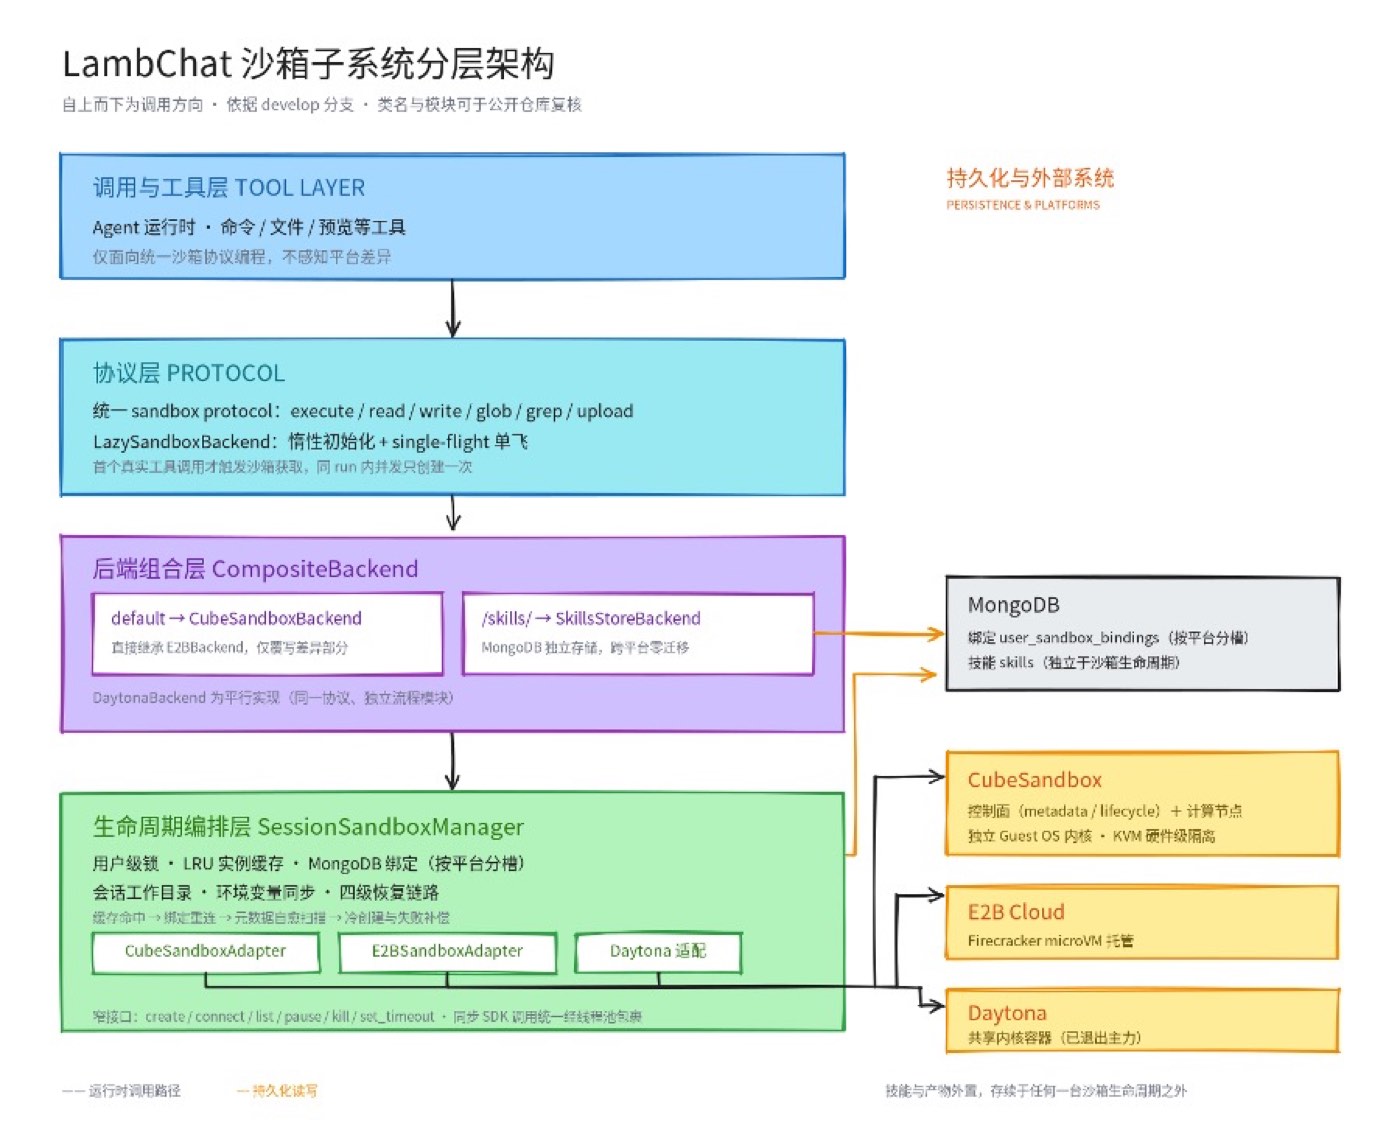
图 1:沙箱四层结构
Layer 1 是 Router(CompositeBackend):路由层,把 /skills/ 路径请求发给独立的技能存储后端,其余全部路由到活跃的沙箱后端。沙箱执行和技能存储因此可以各自独立演进。
Layer 2 是 Backend 层:E2BBackend 是基类实现,CubeSandboxBackend 继承它只覆盖差异部分(ls、get_info、pause),DaytonaBackend 独立实现。切换后端只需要改配置里的一个字段。
Layer 3 是 SessionManager:负责用户到沙箱的绑定关系。每个用户的沙箱 ID 存在 MongoDB 的 user_sandbox_bindings 集合里,同时内存里维护一个 OrderedDict 做 LRU 缓存。
Layer 4 是 Sandbox SDK:直接调用各家 SDK 的原生 API。
三、CubeSandboxBackend 继承了什么,写了什么
CubeSandboxBackend 继承自 E2BBackend,这是有意的设计:CubeSandbox 的 API 兼容 E2B,两者生命周期管理语义一致,只有少量行为差异。继承基类意味着 CubeSandbox 相关的适配代码只有大约 200 行。
具体写了四个方法:
- ls:CubeSandbox 没有原生的文件列表 API,我们在沙箱里跑了一段内联 Python 脚本来实现。
- get_info:返回的沙箱信息字段名有 camelCase 和 snake_case 两种风格,我们做了双向兼容处理。
- pause:CubeSandbox 独有的能力,基类没有,单独实现。
- list_user_sandboxes:CubeSandbox 支持按 metadata.user_id 枚举沙箱,这是 E2B 没有的能力,用来支撑四级查找链。
四、用户级持久绑定 + 四级查找链
LambChat 的设计是:一个用户对应一个沙箱,跨会话共享,沙箱生命周期跟随用户而不是对话。这和常见的会话级绑定不同。
查找一个用户的沙箱,走的是四级查找链:
- 内存缓存命中:进程内的 OrderedDict LRU 缓存,最快路径;
- MongoDB 绑定重连:进程重启后内存缓存丢失,从 user_sandbox_bindings 集合恢复绑定,用 sandbox.connect() 重新连接;
- 枚举已有沙箱复用:如果 MongoDB 里也没有,调 list_user_sandboxes() 按 metadata.user_id 过滤,看看是不是之前创建过但绑定记录丢了;
- 新建沙箱:前三级都没命中才走这一步。
还有一个第五级的兜底逻辑:如果发现同一个用户存在多个沙箱(异常情况,比如并发创建导致的重复),异步清理掉多余的,只保留一个。
五、AutoPause 配置与 resume 后 504 的真实踩坑
创建沙箱时通过 lifecycle 字段配置 on_timeout=pause 和 auto_resume=true。沙箱空闲超时后自动 pause,下次请求时自动恢复,这是我们选 CubeSandbox 的核心原因之一。
实际跑起来之后,我们发现了一个比较隐蔽的问题:pause 之后 resume,控制面返回 running,但数据面可能还没真正就绪。用户请求到达时,envd 会返回 504 Gateway Timeout,而不是我们期望的正常响应。
当时的排查过程:
现象是用户报告"沙箱命令执行失败,提示超时"。我们一开始怀疑是 LambChat 侧的逻辑问题,检查了我们的超时设置、重试逻辑,都没问题。然后去看 CubeSandbox 侧,sandbox.get_info() 返回的状态是 running,看起来一切正常。但直接对沙箱执行一个简单命令,返回的是 504。
控制面说 running,数据面说 504,两边对不上。
真正的根因是:CubeSandbox 的 pause/resume 是异步的。resume 触发后,控制面先把状态改成 running,但数据面的 envd 进程需要时间才能完全恢复服务。这个时间窗口内,控制面和数据面的状态是不一致的。
我们的解法是把这个时间窗口当作一种需要主动识别的异常来处理:在 SessionManager 的健康检查里,不仅对控制面状态做判断,还会实际对数据面发一个轻量请求,如果收到 504 就判定为不健康,触发回退到另一个沙箱或新建。
这个 504 容错逻辑,是只有真实踩过坑才会写出来的代码。在文档里看不到,在 API 说明里也没有,只有跑起来才会遇到。
六、Python e2b SDK 的 bash -lc 登录 shell 问题
另一个踩坑来自 Python e2b SDK 的默认行为:执行命令时默认用 bash -lc 包装,这会启动一个新的登录 shell。
单次执行没问题,但如果任务分两个阶段执行——比如先装依赖再跑脚本——第一阶段设置的环境变量、PATH 不会带到第二阶段,因为每次执行都是一个新的登录 shell。
这个问题的根因不在 CubeSandbox 本身,而在 E2B SDK 协议默认的执行方式。我们的处理方式是在两阶段任务之间显式重新设置需要延续的环境变量,不依赖 shell 状态自动延续。
七、迁移工作量评估
从默认后端切到 CubeSandbox,实际改动的代码量:
| 改动点 | 代码量 |
|---|---|
| CubeSandboxBackend 类(继承 + 4 个方法) | 约 200 行 |
| SessionManager 里加 CubeSandbox 特有的枚举查找 | 约 50 行 |
| 504 健康检查容错逻辑 | 约 30 行 |
| 配置项(CUBE_API_URL、CUBE_TEMPLATE 等) | 约 10 个字段 |
| 总计 | 约 300 行 |
这个量级,对一个已经在跑的 Agent 平台来说,是一天内可以完成的工作量。前提是:CubeSandbox 兼容 E2B 协议,我们的 E2BBackend 基类可以直接继承。如果两者协议不兼容,这个量级会完全不同。
八、我们没用到的 CubeSandbox 能力
LambChat 目前没有用到的 CubeSandbox 能力:
- 快照 API:完全没碰。WeKnora 把快照做成了技能镜像缓存层,我们目前的技能存储走的是独立后端,没有走快照路径。
- 模板管理:模板 ID 是外部配置传入的,没有自动创建或重建模板的逻辑。
- 网络策略:allowInternetAccess、allowOut、denyOut 都没用,默认放行。
这三块是 CubeSandbox 的差异化能力,我们的集成深度还没到那里。如果后续技能存储要改成快照路径,或者需要按租户控制网络策略,这些是下一步会评估的方向。
九、给其他团队的参考
如果你也在做 Agent 平台,在选沙箱后端,我们的建议是:
- 先想清楚绑定粒度:是会话级还是用户级?这决定了你的查找链和生命周期管理复杂度。用户级绑定更简单,但要处理好"一个用户多个沙箱"的异常清理。
- E2B 兼容性是杠杆:如果你已经有 E2B 后端,CubeSandbox 的兼容协议能让你以很小的代价接入。继承基类、覆盖差异,比从零写适配层快得多。
- pause/resume 的状态不一致要当成异常处理:控制面 running 不等于数据面就绪,健康检查要打到数据面。
- bash -lc 的问题提前知道:两阶段任务之间的环境变量要显式传递,不要依赖 shell 状态。
- 差异化能力可以后补:快照、模板管理、网络策略这些 CubeSandbox 的差异化能力,初期可以先用最小集成跑通,后续按需接入。
十、写在最后
从默认后端切到 CubeSandbox,我们总共改了大约 300 行代码,用了一天时间。这个量级的前提,是 CubeSandbox 兼容 E2B 协议,我们的 E2BBackend 基类可以直接继承。
真正花时间的不是写代码,而是踩坑:四级查找链的设计、504 容错逻辑、bash -lc 的环境变量问题。这些坑不在文档里,只有跑起来才会遇到。我们希望这篇文章能让下一个做同样事情的人,少踩几个。